Pour migrer 1 000 comics d'Excel ou Google Sheets vers My Comics Collection en 2026, exporte ta feuille en CSV UTF-8, reporte tes colonnes dans le modèle d'import téléchargeable de MCC (N° comics, Titre, État, Prix, Grade CGC, Collection, etc.) et charge le fichier via « Importer la collection ». MCC reconnaît les colonnes à leurs entêtes, affiche un aperçu et met à jour les fiches dont le numéro existe déjà au lieu de les dupliquer. Une migration sérieuse prend 60 à 90 minutes pour 1 000 lignes, vérification post-import comprise.
Tout collectionneur qui a tenu un Excel ou un Google Sheets pendant trois ans connaît la sensation : la feuille devient lente, les onglets se multiplient, les formules cassent dès qu'on ajoute une colonne. À 1 000 lignes, le tableur ne suffit plus, et la migration vers une application dédiée comme My Comics Collection (MCC) devient mécaniquement plus rentable. Encore faut-il que cette migration ne casse pas trois ans de saisie patiente. C'est tout l'enjeu d'un import CSV bien préparé : conserver la donnée brute, gagner le suivi de la cote et ne perdre aucune ligne en route.
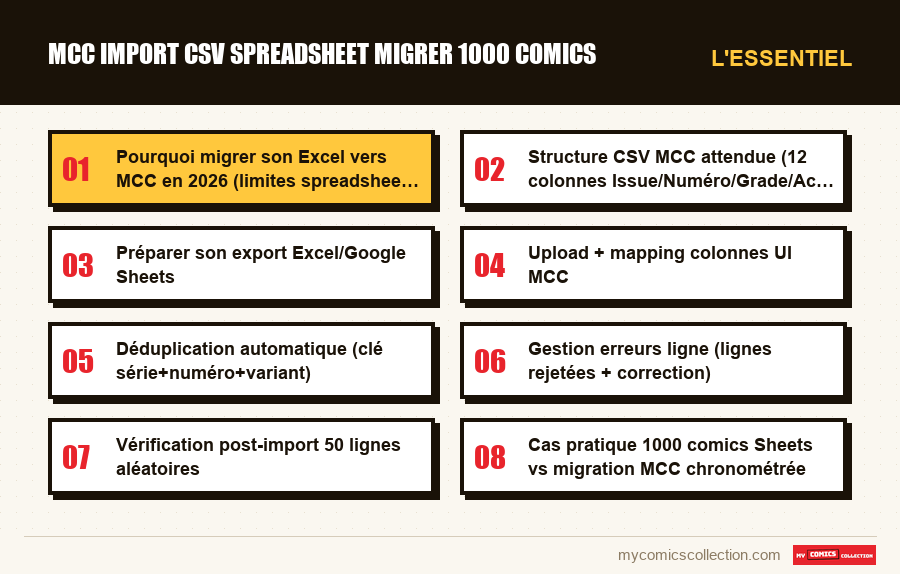
Ce guide décompose le processus complet pour 2026 : pourquoi un spreadsheet plafonne à 500-700 entrées avant de devenir une corvée, quelle structure CSV MCC attend exactement, comment préparer son export Excel ou Google Sheets sans surprise, comment se déroulent l'upload et l'aperçu dans MCC, comment MCC traite un numéro déjà présent, comment repérer et corriger les lignes fautives, et comment vérifier l'intégrité du résultat sur un échantillon aléatoire. Un cas pratique chronométré sur 1 000 comics ferme le tour de la question.
Pourquoi migrer son Excel vers MCC en 2026 (limites spreadsheet à 500+ comics)
Le tableur est l'outil par défaut de presque tous les collectionneurs qui démarrent. Il est gratuit, familier, ouvert sur tous les appareils, et zéro friction au lancement. Le problème n'apparaît pas avant 200 comics. Il devient visible vers 500. Il devient insupportable au-delà de 700. Trois mécaniques expliquent ce plafond.
La première mécanique est la fatigue de saisie. Sur un tableur, chaque comic ajouté demande de renseigner manuellement 8 à 12 colonnes : série, numéro, éditeur, date de publication, créateurs, état, prix payé, date d'achat, source, lieu de stockage, valeur courante, notes. À 30 secondes par ligne (rythme expert), c'est 5 heures de saisie nette pour 600 entrées. À 60 secondes par ligne (rythme réaliste avec recherches d'éditeurs et de dates), c'est 10 heures. Et chaque correction d'orthographe d'éditeur ou de série propage l'erreur sur des centaines de lignes que rien ne harmonise automatiquement. L'article cataloguer ses comics en ligne : app vs spreadsheet chiffre précisément cet écart de temps de saisie entre les deux familles d'outils.
La deuxième mécanique est la perte de cohérence. Sur Google Sheets ou Excel, rien n'empêche un utilisateur de taper "Marvel", "marvel", "Marvel Comics", "Marvel comics" ou "MAR" dans la colonne éditeur. Au bout de trois ans de saisie discontinue, on retrouve cinq à huit variantes pour le même label. Les tris et filtres deviennent peu fiables, les statistiques par éditeur sont fausses, et il faut prévoir une journée de "nettoyage" tous les six mois. Aucune validation native ne verrouille la saisie au format prévu, sauf si l'on monte un système de Data Validation par menu déroulant qui demande lui-même une heure de configuration et qui casse au premier collage de données externes.
La troisième mécanique est la perte de valeur. Un spreadsheet ne sait rien de la cote actuelle de tes comics. La colonne Valeur_courante est saisie manuellement, datée d'il y a six mois, et ne reflète pas le marché 2026. Pour une collection à dimension d'investissement, c'est rédhibitoire. Les solutions de rattrapage (fonction GOOGLEFINANCE détournée, scripts AppScript, intégrations Zapier) demandent toutes une compétence technique que la majorité des collectionneurs n'a pas envie d'acquérir. Une application dédiée embarque une cote native, recalculée chaque jour à partir des annonces eBay en cours.
Le verdict pratique : un spreadsheet est excellent jusqu'à 300 comics, gérable jusqu'à 500, pénible entre 500 et 1 000, et franchement contre-productif au-delà. À 1 000 comics, la migration vers MCC se rembourse en quelques mois grâce au gain de temps de saisie et à la fiabilité retrouvée de la donnée. La condition est de réussir l'import sans perdre l'historique.
Structure CSV MCC attendue (les colonnes du modèle d'import)
L'écran d'import MCC accepte un fichier CSV (un classeur Excel s'enregistre dans ce format en deux clics) et reconnaît chaque colonne à son entête. Il n'existe pas d'écran pour associer les colonnes à la main : le plus sûr est de télécharger le modèle proposé à côté de l'import et d'y reporter tes données. La règle est simple : plus ton CSV ressemble au schéma cible, plus l'import est rapide et fiable.
Les principales colonnes du modèle d'import MCC
- N° comics (obligatoire) : le numéro du comic. Les lignes sans numéro sont ignorées à l'import.
- Titre, Scénariste, Dessinateur, Date de publication, ISBN (optionnels) : les informations descriptives du comic.
- Possédé (Oui/Non) : si tu possèdes le comic. Oui et Non peuvent être écrits dans l'une des huit langues de l'application.
- État et Prix (optionnels) : état de l'exemplaire et prix payé.
- CGC gradé, Grade CGC, N° de certification CGC (optionnels) : pour les slabs. Format décimal (9.8 et non 98).
- Signé, Signé par (optionnels) : signature et nom du signataire.
- Variante (Oui/Non) et Ratio de variante (optionnel) : un ratio saisi 25 ou 1/25 est enregistré en 1:25.
- Annuel, Doublon (Oui/Non, optionnels).
- Description (texte long optionnel) : commentaire libre, utile pour signaler un défaut, une date d'achat ou un contexte d'achat particulier.
- Collection (optionnel) : nom d'une collection existante dans MCC, à laquelle la ligne est rattachée.
Seul le numéro est strictement obligatoire. Les autres colonnes sont optionnelles et peuvent être complétées plus tard depuis l'interface MCC. Si le numéro manque sur une ligne, MCC ignore cette ligne sans message ; il n'y a pas de rapport d'erreurs. Mieux vaut donc vérifier la complétude des colonnes critiques avant l'upload plutôt que de devoir corriger ligne par ligne après coup.
Le format de date mérite une attention particulière. Excel et Google Sheets stockent les dates dans différents formats régionaux (15/03/2025 en FR, 3/15/2025 en US, 2025-03-15 en ISO). MCC reprend le contenu des colonnes date tel qu'il figure dans le fichier, sans le vérifier : des formats mélangés arrivent donc mélangés dans la collection. La plus pertinente pratique consiste à reformater toutes les colonnes date en ISO avant l'export CSV, via une fonction TEXT(A1,"yyyy-mm-dd") sur Sheets ou =TEXTE(A1;"aaaa-mm-jj") sur Excel français.
Les colonnes monétaires demandent la même rigueur. MCC lit correctement des montants simples comme 12.50 ou 12,50, même avec un symbole de devise, mais bute sur les séparateurs de milliers (1,250.00 ou 1 250,00) : un "1 250,50 €", tel que le produit volontiers un export Excel français, devient une valeur fausse. Le séparateur de milliers doit donc être retiré avant export. La fonction CNUM ou VALEUR sur Excel et VALUE sur Sheets convertit proprement en nombre exploitable.
Préparer son export Excel/Google Sheets
La qualité de l'import dépend à 80 % de la qualité du fichier source. Cinq étapes de préparation minimisent le travail correctif post-import.
Étape 1 : auditer son tableur existant. Ouvre ta feuille principale et compte le nombre de lignes vraies (sans les entêtes, sans les lignes de séparation, sans les totaux automatiques). Si tu as plusieurs onglets (par exemple un onglet par éditeur ou par année), liste-les. Décide en amont si tu importes tout en une seule fois (recommandé) ou par lots (utile au-delà de 3 000 entrées pour limiter le risque en cas d'erreur). Sur 1 000 comics, un seul import est largement gérable. L'article inventaire 1 000 comics en 90 minutes : méthode bulk donne le cadre méthodologique général de tout traitement de volume.
Étape 2 : harmoniser les libellés. C'est l'étape la plus chronophage mais la plus payante. Filtre la colonne Éditeur sur l'ensemble des valeurs distinctes (Données → Filtre → Sélectionner les valeurs uniques sur Excel, ou Données → Créer un filtre puis cliquer sur la flèche sur Sheets). Tu découvres souvent 5 à 10 variantes pour un même éditeur ("Marvel", "Marvel Comics", "MAR", "M"). Choisis une forme canonique (Marvel) et utilise Rechercher-Remplacer pour harmoniser. Répète l'opération pour la colonne Série, où les variantes orthographiques sont fréquentes (Amazing Spider-Man / The Amazing Spider-Man / Amazing SpiderMan). Cette harmonisation prend 20 à 40 minutes sur 1 000 lignes mais elle évite des centaines de corrections après l'import.
Étape 3 : renommer les colonnes. Aligne les entêtes de ton tableur sur ceux du modèle MCC décrit plus haut. Ce n'est pas une finition mais une condition : MCC reconnaît une colonne uniquement à son entête et ignore toute colonne dont il ne connaît pas le nom. Si tu as une colonne "Cout" qui correspond au "Prix" du modèle, renomme-la avant l'export. Les colonnes ambiguës ("Info", "Divers", "Autre") se regroupent au mieux dans la colonne "Description".
Étape 4 : convertir les formats. Reformate toutes les colonnes date en ISO YYYY-MM-DD via une formule TEXT. Convertis tous les montants en nombre décimal avec point séparateur. Vérifie la colonne Grade : si tu as mélangé des grades CGC (9.8) et des notes texte (NM), splitte en deux colonnes État et Grade CGC. Les comics non slabbed ont une note texte (NM, VF, etc.), les comics slabbed ont une note CGC numérique. Mélanger les deux dans une seule colonne mélange aussi, dans MCC, état brut et note du slab.
Étape 5 : exporter en CSV UTF-8. Sur Excel, Fichier → Enregistrer sous → CSV UTF-8 (délimité par des virgules) (*.csv). Sur Google Sheets, Fichier → Télécharger → Valeurs séparées par une virgule (.csv). L'encodage UTF-8 est obligatoire : sans lui, les accents français (é, è, à, ç) deviennent des caractères corrompus à l'import (é, è). Un fichier .xlsx est refusé : l'import n'accepte que le format CSV. Pour les workflows d'export récurrents, l'article export collection CSV comics : comment faire détaille les pièges et options d'encodage selon les logiciels source.
Upload et aperçu dans l'interface MCC
L'import MCC se trouve dans les Réglages de l'application, rubrique Import / Export, bouton « Importer la collection » ; le modèle à télécharger est juste à côté. L'interface accepte un fichier glissé-déposé ou sélectionné depuis le navigateur de fichiers. Pour 1 000 comics sans images, le fichier pèse 100 à 200 ko.
Une fois le fichier chargé, MCC lit la ligne d'entêtes et associe chaque colonne à un champ d'après son nom. Il reconnaît les entêtes du modèle dans les huit langues de l'application, ainsi que quelques anciens libellés anglais. Les colonnes portant un autre nom sont ignorées sans message.
Le piège classique, c'est de confondre date de publication (date où l'éditeur a sorti le comic) et date d'achat (date où tu l'as acquis). Les deux dates existent souvent dans le tableau source mais avec des noms peu explicites ("Date 1", "Date 2"). Le modèle ne connaît que la date de publication : renomme donc la bonne colonne en "Date de publication" et reporte si besoin la date d'achat dans la Description. Une inversion produit 1 000 comics affichés comme "publiés en 2024", erreur qui demande une correction massive post-import.
Le deuxième piège concerne les variants. Dans le modèle, "Variante" est un champ Oui/Non, complété par la colonne "Ratio de variante" ; sans indication, le comic est traité comme une couverture régulière. La lettre de couverture (A, B, C) se note dans la Description. Attention : si une fiche porte déjà le même numéro dans MCC, la ligne met cette fiche à jour au lieu d'en créer une seconde.
Avant l'import, MCC affiche un aperçu : le nombre de lignes détectées, dont combien seront ajoutées et combien mises à jour, puis les 8 premières lignes avec numéro, titre, possédé, état, prix et grade CGC. Lis cet aperçu attentivement avant de confirmer l'import. Si quelque chose te paraît bizarre (un prix qui manque, un titre dans la mauvaise colonne, beaucoup plus de mises à jour que prévu), c'est qu'un entête ou un numéro est mal interprété. Mieux vaut corriger maintenant que réparer 1 000 fiches à la main.
L'import lui-même dure 30 à 90 secondes pour 1 000 lignes selon la connexion. À la fin, MCC indique le nombre de lignes importées. Compare-le au nombre de lignes de ton fichier : un écart signale des lignes sans numéro, qui ont été ignorées.
Numéros déjà présents : mise à jour plutôt que doublon
La comparaison avec ta collection existante est ce qui fait gagner le plus de temps à long terme. Elle évite d'avoir deux fiches Amazing Spider-Man #800 parce qu'on a importé deux fois le même fichier (export de mai, ré-export de juin).
La clé de cette comparaison est uniquement le numéro : MCC compare la colonne "N° comics" de chaque ligne aux numéros déjà présents dans ta collection. Le titre de série et la variante ne sont ni normalisés ni comparés.
Concrètement, à l'import, MCC parcourt chaque ligne et la compare à ta collection. Deux résultats sont possibles. Cas 1 : le numéro n'existe pas encore, la ligne crée une nouvelle fiche. Cas 2 : le numéro existe déjà, MCC met à jour la fiche existante, uniquement avec les colonnes présentes dans ton fichier ; les colonnes absentes laissent les données en place. Il n'y a ni statut « à vérifier » ni choix entre écraser et conserver.
La gestion des multi-exemplaires est un cas spécial. Si tu possèdes deux copies de Amazing Spider-Man #1 (un slab CGC 9.4 et une reading copy en VF), tu veux deux fiches distinctes dans MCC, pas une fusion. Or une seconde ligne avec le même numéro mettrait simplement à jour la première fiche à l'import. Importe donc un seul exemplaire par numéro, puis ajoute le second directement dans l'application comme doublon. Pour les collectionneurs qui ont systématiquement plusieurs copies, l'article importer sa collection comics dans une application détaille le pattern multi-exemplaires.
Gestion des erreurs (lignes ignorées ou mal lues)
Aucun import sur 1 000 lignes ne passe à 100 %. Tabler sur 2 à 5 % de lignes problématiques est réaliste. Sur 1 000 entrées, c'est 20 à 50 lignes à corriger manuellement. MCC ne fournit pas de rapport d'erreurs : les lignes sans numéro sont ignorées, toutes les autres sont reprises telles qu'elles figurent dans le fichier. Les erreurs se découvrent donc au contrôle, et connaître leurs causes typiques accélère la correction.
Les erreurs de format sont les plus fréquentes : une date aux formats mélangés, un montant avec séparateur de milliers, un champ Oui/Non contenant une valeur comme "x". MCC reprend ces valeurs sans avertir. Le plus simple est de corriger directement dans le CSV source et de relancer un import partiel sur ces lignes uniquement : leurs numéros existant déjà, elles mettent à jour les fiches en place.
Les numéros manquants sont la deuxième cause. Si le numéro est dans une autre colonne ou absent, MCC ignore la ligne. Vérifie avant l'upload que la colonne "N° comics" est remplie sur chaque ligne.
Les erreurs de cohérence sont les plus subtiles. Tu as indiqué un grade CGC sur une ligne sans mettre "CGC gradé" à Oui, ou un état texte (NM) avec un numéro de certification CGC renseigné, ce qui est contradictoire. MCC ne signale pas ces contradictions : tu ne les trouves qu'au contrôle. Sur 1 000 lignes saisies pendant trois ans avec des conventions évolutives, ce type d'erreur représente souvent la moitié des corrections.
Bonne pratique : ne corrige pas les erreurs une par une dans l'interface MCC, c'est plus lent. Regroupe les lignes concernées dans Excel ou Sheets, corrige-les, et relance un import partiel ne contenant que les lignes corrigées. Sur 50 erreurs, le gain de temps est de 70 à 80 % par rapport à une correction unitaire dans l'app.
Vous collectionnez cette série ?
Suivez ce que vous possédez, ce qu'il vous manque et ce que vaut votre collection. Essai de 7 jours.
Commencer mon essai →Vérification post-import 50 lignes aléatoires
L'erreur après une migration de 1 000 comics, c'est de considérer l'import comme terminé dès que la barre de progression atteint 100 %. La vérification post-import est non négociable : sans elle, on découvre les erreurs silencieuses des semaines ou mois plus tard, quand il est trop tard pour les rattacher à un état antérieur fiable.
La méthode des 50 lignes aléatoires est rapide et statistiquement valide. Sur 1 000 imports, contrôler 50 lignes (5 %) donne une marge d'erreur de l'ordre de ±3 %, ce qui suffit largement pour détecter des problèmes systémiques. Tirer ces 50 lignes vraiment au hasard demande une discipline : ne pas sélectionner que les premières lignes (souvent les mieux saisies, donc biais), ni les dernières (souvent les plus récentes, donc encore en mémoire). La fonction RAND ou ALEA sur Sheets et Excel permet de générer 50 indices aléatoires entre 1 et 1 000, puis d'ouvrir chaque ligne correspondante dans MCC.
Pour chaque ligne échantillonnée, vérifie quatre points : la série et le numéro (les deux clés primaires, qui ne doivent jamais être incorrects), la date de publication (vérifie sur ComicVine ou League of Comic Geeks que la date affichée dans MCC correspond à celle réelle), le prix payé et la valeur (assure-toi qu'aucune virgule mal interprétée n'a transformé 12.50 en 1250 ou inversement), le variant et le grade (vérifie qu'un variant cover n'a pas été perdu en Regular et qu'un grade CGC est bien en mode slabbed et non en raw).
Le temps de vérification est court : 30 à 60 secondes par ligne, soit 25 à 50 minutes pour les 50 lignes. C'est négligeable par rapport au temps de migration totale, mais c'est ce qui fait la différence entre un import propre et un import bancal qui empoisonne la base pendant des années. Si plus de 3 erreurs apparaissent sur 50 lignes (taux > 6 %), c'est qu'un entête ou un format est systématiquement faux. Mieux vaut alors corriger la cause racine dans le fichier source et réimporter : les numéros déjà présents sont mis à jour avec les bonnes valeurs.
Au-delà de l'échantillon aléatoire, un check global sur les agrégats est utile. Compte le nombre total de fiches importées dans MCC et compare-le au nombre de lignes du CSV source : un écart signale des lignes ignorées ou des numéros présents plusieurs fois dans le fichier. Compare le total investi affiché dans les statistiques MCC à la somme des prix dans ton tableur d'origine : un écart significatif signale un problème de format monétaire. Compte les fiches de chaque collection dans MCC et compare avec ton tableur : un écart signale un nom de collection que MCC n'a pas su rattacher. Ces trois checks globaux prennent dix minutes et détectent 80 % des erreurs systémiques.
Pour ancrer la sécurité de cette migration, exporte immédiatement après vérification un backup CSV depuis MCC et stocke-le selon la règle 3-2-1 : 3 copies, 2 supports différents, 1 hors site. L'article backup cloud comics : règle 3-2-1 applique ce principe à une collection numérique. Disposer d'un backup post-import t'évite de tout reperdre si tu manipules mal MCC dans les jours qui suivent.
Cas pratique 1000 comics Sheets vs migration MCC chronométrée
Pour rendre concret le bénéfice de la migration, voilà un cas pratique chronométré sur une collection réelle de 1 000 comics gérée pendant quatre ans sur Google Sheets, puis migrée vers MCC. Les temps sont mesurés au chronomètre sur un échantillon représentatif.
Phase 1 : audit du Sheets source. 15 minutes. Comptage des lignes vraies (1 047, dont 1 002 utiles et 45 lignes de séparation/totaux à supprimer). Listing des onglets (3 onglets : Marvel, DC, Indé). Vérification des entêtes (12 colonnes mais avec noms FR libres : "Editeur", "Cote actuelle", "Cout d'achat", etc.). Décision : import en une fois, après harmonisation des libellés.
Phase 2 : harmonisation des libellés. 35 minutes. Colonne Éditeur : 8 variantes ramenées à 4 valeurs canoniques (Marvel, DC, Image, Indé). Colonne Série : 12 fautes d'orthographe corrigées via Rechercher-Remplacer. Colonne État : conversion de 60 lignes mélangées (notes CGC dans la colonne État) vers deux colonnes séparées. Colonne Source_achat : 5 variantes ramenées à 3 valeurs (eBay, Comic shop, Convention).
Phase 3 : conversion des formats. 12 minutes. Reformat des 1 002 dates en ISO via TEXT. Conversion des 1 002 montants en nombre décimal avec point séparateur. Vérification d'absence de symboles € résiduels.
Phase 4 : export CSV UTF-8. 3 minutes. Fichier → Télécharger → CSV. Vérification rapide dans un éditeur de texte que les accents sont préservés.
Phase 5 : upload et aperçu MCC. 8 minutes. Entêtes alignés sur le modèle ("Cout d'achat" devient Prix, "Cote actuelle" est retirée). Glissé-déposé du CSV. Aperçu vérifié. Lancement.
Phase 6 : import et résultats. 1 minute 20 secondes (temps d'import effectif). MCC indique le nombre de lignes importées ; le contrôle révèle 8 lignes fautives (4 erreurs de format date, 2 numéros manquants, 2 erreurs de cohérence grade).
Phase 7 : correction des erreurs. 18 minutes. Correction des 8 lignes dans Excel. Ré-import partiel, qui met à jour les fiches concernées ou crée celles qui manquaient.
Phase 8 : vérification 50 lignes aléatoires. 32 minutes. Génération de 50 indices aléatoires, ouverture de chaque ligne, vérification série, numéro, date, prix, variant, grade. 1 erreur détectée (un grade CGC 9.4 affiché en 9.6 à cause d'une saisie ambiguë dans le tableau source : corrigé en 30 secondes). Tous les autres champs sont fidèles à la source.
Phase 9 : checks globaux et backup. 8 minutes. Comparaison du nombre de fiches (1 002 source vs 1 002 dans MCC : OK). Somme des prix (3 847 € source vs 3 847 € MCC : OK). Comptage des fiches par collection (OK). Export d'un backup CSV depuis MCC, stockage local + cloud + clé USB.
Total de la migration chronométrée : 2 heures 12 minutes pour 1 000 comics. Comparé aux 40+ heures qu'aurait demandé une ressaisie manuelle dans une nouvelle application sans import, c'est un gain de 95 % de temps. Comparé au temps de saisie initial étalé sur quatre ans (estimé à 60 heures sur Sheets), c'est aussi un gain net car la migration capitalise sur le travail déjà fait.
Pour évaluer la valeur réelle de la collection une fois migrée et bénéficier de la cote eBay mise à jour chaque jour de MCC, l'option d'estimation gratuite donne en quelques minutes un range de valorisation actualisé. Pour explorer le catalogue mondial de MCC (plus de 2,6 millions de numéros), qui accélère les saisies futures, voir le catalogue comics. Les collectionneurs débutants qui hésitent encore à investir dans une app peuvent consulter le guide débutant collectionneur comics, et les collectionneurs FR le pendant guide collectionneur comics en France.
Disclaimer méthodologique. Les temps de migration chronométrés sont issus d'un cas réel sur une collection de 1 000 comics gérée pendant quatre ans sur Google Sheets. Les durées réelles varient selon la propreté du tableur source, la familiarité de l'utilisateur avec les outils, et la complexité des cas particuliers (multi-exemplaires, comics indé non répertoriés). Les estimations de gain de temps sont des illustrations et ne constituent ni une garantie de performance ni un conseil patrimonial. La valorisation de MCC repose sur les annonces eBay en cours, mise à jour chaque jour, et reflète des estimations de marché qui peuvent évoluer.
FAQ
Combien de temps prend la migration de 1 000 comics depuis Excel vers MCC ?
En conditions réelles et avec un tableur source raisonnablement propre, la migration complète prend 2 heures à 2 heures 30, vérification post-import comprise. Le temps se décompose ainsi : 50 minutes de préparation du fichier (audit, harmonisation, conversion des formats), 10 minutes d'upload et de contrôle de l'aperçu dans l'interface MCC, 20 minutes de correction des lignes fautives, 40 minutes de vérification sur 50 lignes aléatoires et checks globaux. Sur un tableur très désorganisé avec plusieurs onglets et libellés incohérents, prévoir 3 à 4 heures. Sur un tableur déjà nettoyé, 90 minutes suffisent.
Que se passe-t-il si certaines colonnes de mon Excel n'existent pas dans MCC ?
Les colonnes dont MCC ne connaît pas l'entête sont ignorées à l'import sans bloquer le processus. Si tu as une colonne "Note de lecture" ou "Recommandé par" qui n'a pas d'équivalent dans le modèle MCC, soit sa donnée est perdue, soit tu la reportes dans la colonne Description (la donnée est conservée comme texte libre sur la fiche). La plus pertinente pratique consiste à concaténer plusieurs colonnes secondaires en une seule colonne Description avant l'export, ce qui préserve toute l'information dans un champ unique.
Comment importer des comics qui n'existent pas dans la base MCC ?
L'import ne compare pas les lignes au catalogue MCC : chaque ligne qui porte un numéro est reprise, même pour une série indé peu connue. Pour ces comics, crée d'abord une collection dédiée dans MCC et indique son nom dans la colonne Collection, pour qu'ils ne se mêlent pas aux autres séries.
Peut-on annuler un import si on découvre une erreur massive après coup ?
MCC n'a pas de bouton d'annulation pour un import. Les fiches créées se suppriment d'un coup grâce à la sélection multiple, et les fiches mises à jour se corrigent en réimportant les bonnes valeurs. D'où l'importance d'un export CSV de sauvegarde avant l'import et de la vérification sur 50 lignes aléatoires juste après.